腾讯开源的分布式数据库,我把源码翻了一遍
腾讯开源的分布式数据库,我把源码翻了一遍
OpenTenBase 的官网上写着 HTAP。
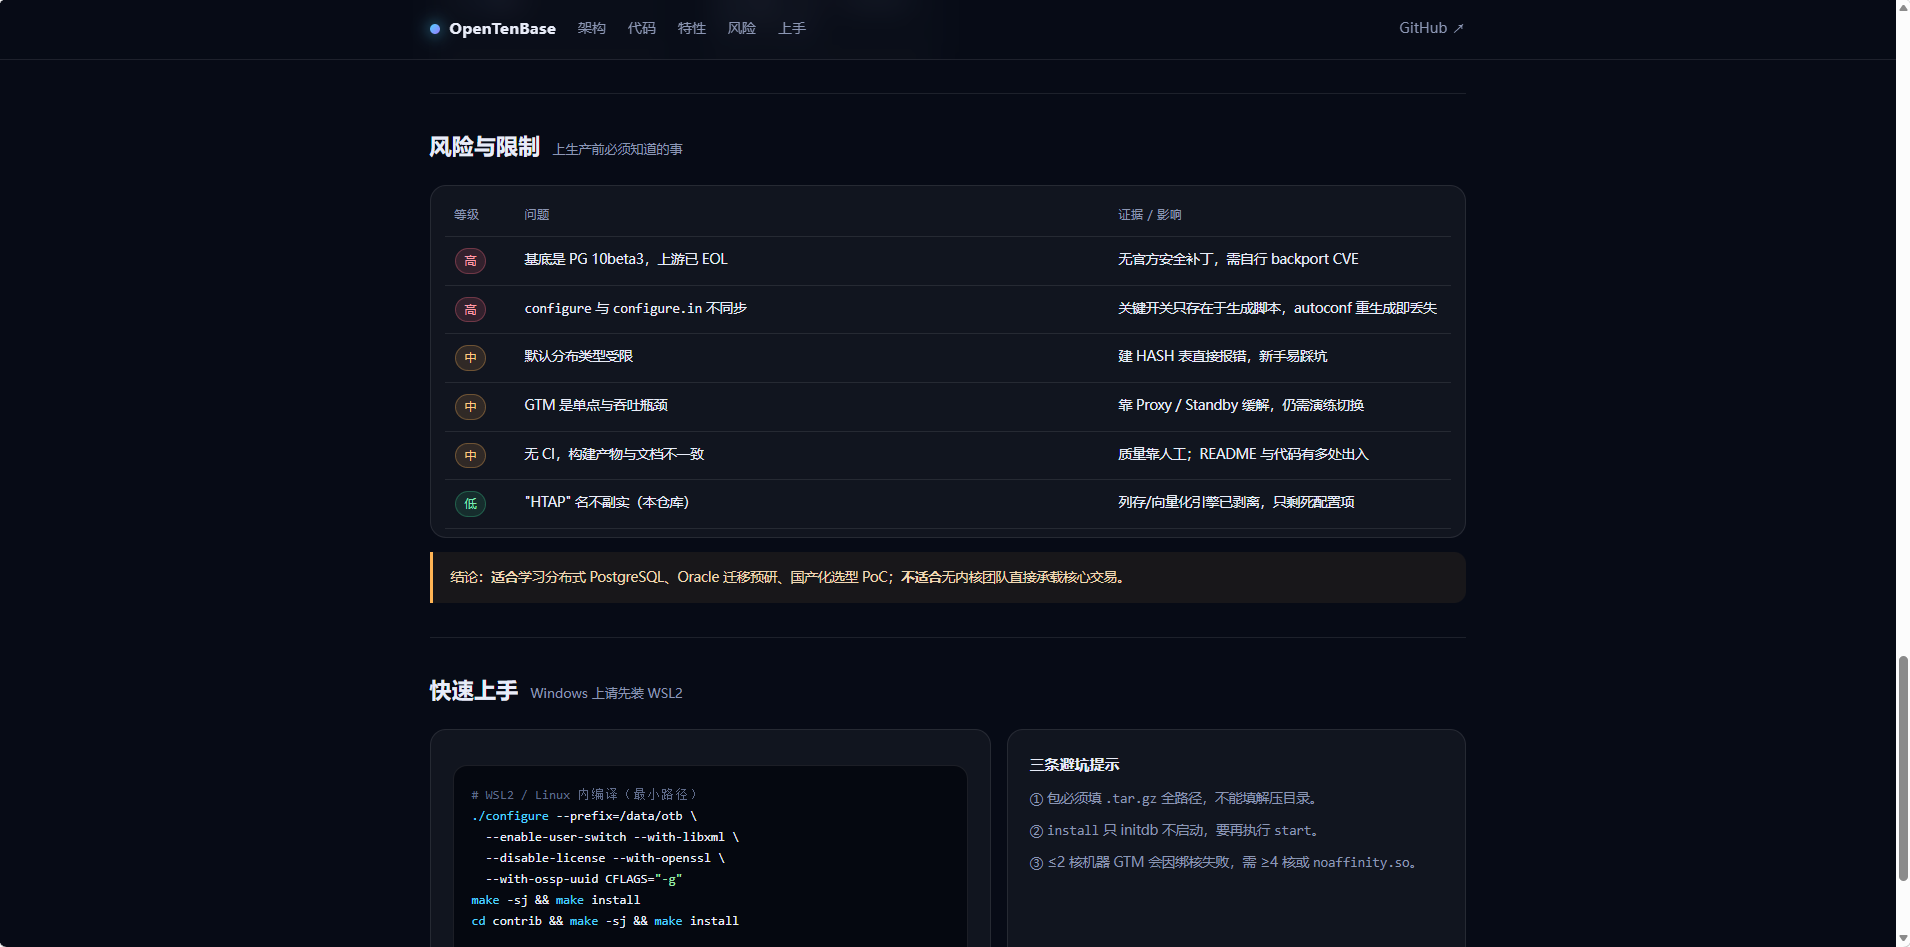
但我把它的源码拉下来,翻遍整个仓库,没找到列存引擎——只剩一个 --with-colblocksize 的编译选项,和一行 “disable create unlogged column table temporarily” 的注释。
这不是黑它。恰恰相反,一个能编译、能跑、有完整分布式事务的数据库,比 PPT 上的 HTAP 有意思得多。
于是我花了一个下午,把它的架构、代码和坑都翻了一遍。
先说结论:它是一台改装得很彻底的旧底盘。底盘是 PostgreSQL 10,改装件是分布式事务、分片和 Oracle 兼容。它能开,有些路况只有它能开,但你需要懂得维修它。
超链接 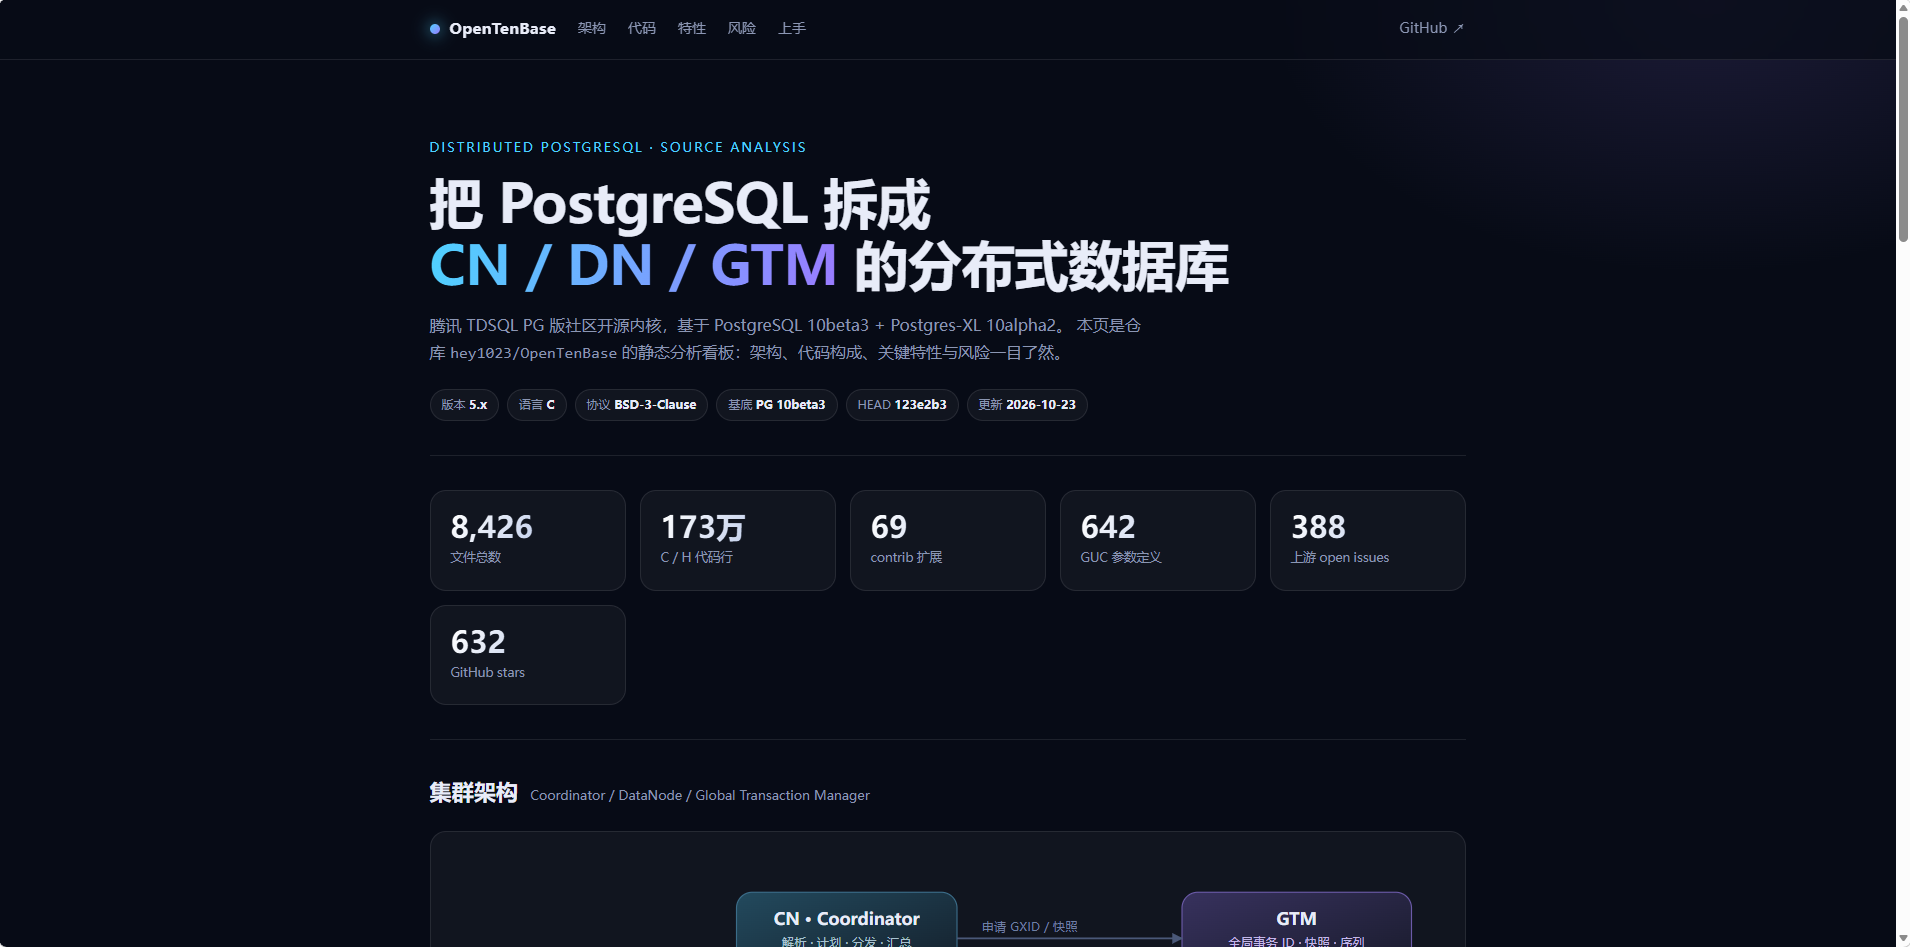
一、它到底是什么
一句话:腾讯 TDSQL PG 版的社区开源内核,由开放原子基金会托管,仓库在 OpenTenBase 组织下。
它的底座写得很直白,configure.in 第一行就是 PostgreSQL 10beta3 (Postgres-XL 10alpha2)。也就是说,它是 PostgreSQL 10 加 Postgres-XL 的分布式改造,而不是从零写起的数据库。
这里要澄清一个常见误解。官网说 OpenTenBase“包含两个内核”,但那是整个项目的版图——本仓库只有 PostgreSQL 内核,MySQL 内核 TXSQL 在别的地方。
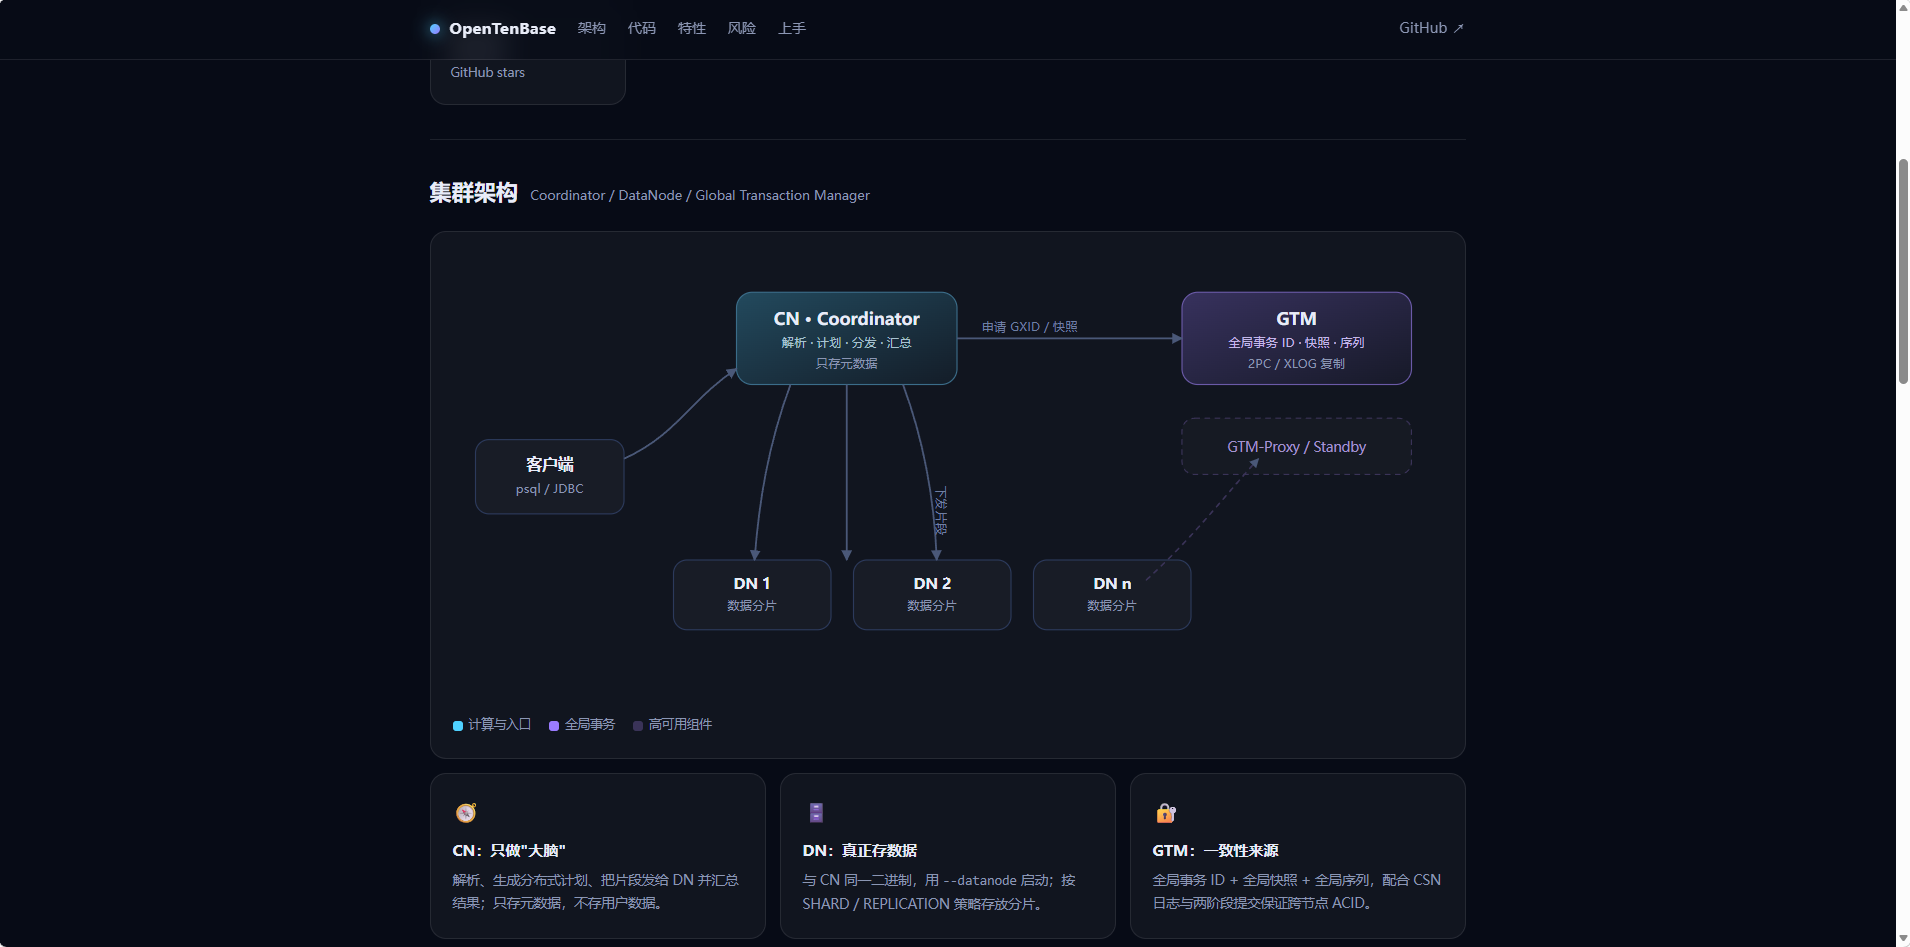
它的集群由三个角色组成:
CN(Coordinator):负责解析、生成分布式计划、把查询片段发给 DN、汇总结果。它只存元数据,不存用户数据。
DN(DataNode):真正存数据、执行片段。和 CN 是同一个二进制,靠 --coordinator / --datanode 启动参数区分。
GTM(Global Transaction Manager)**:独立进程,发放全局事务 ID、全局快照和全局序列,是跨节点一致性的来源。
这个结构决定了它的定位:它是 shared-nothing 的 MPP 数据库,不是“分库分表中间件”。中间件不碰存储引擎,而 OpenTenBase 连执行器和事务层都改了。
二、代码成色
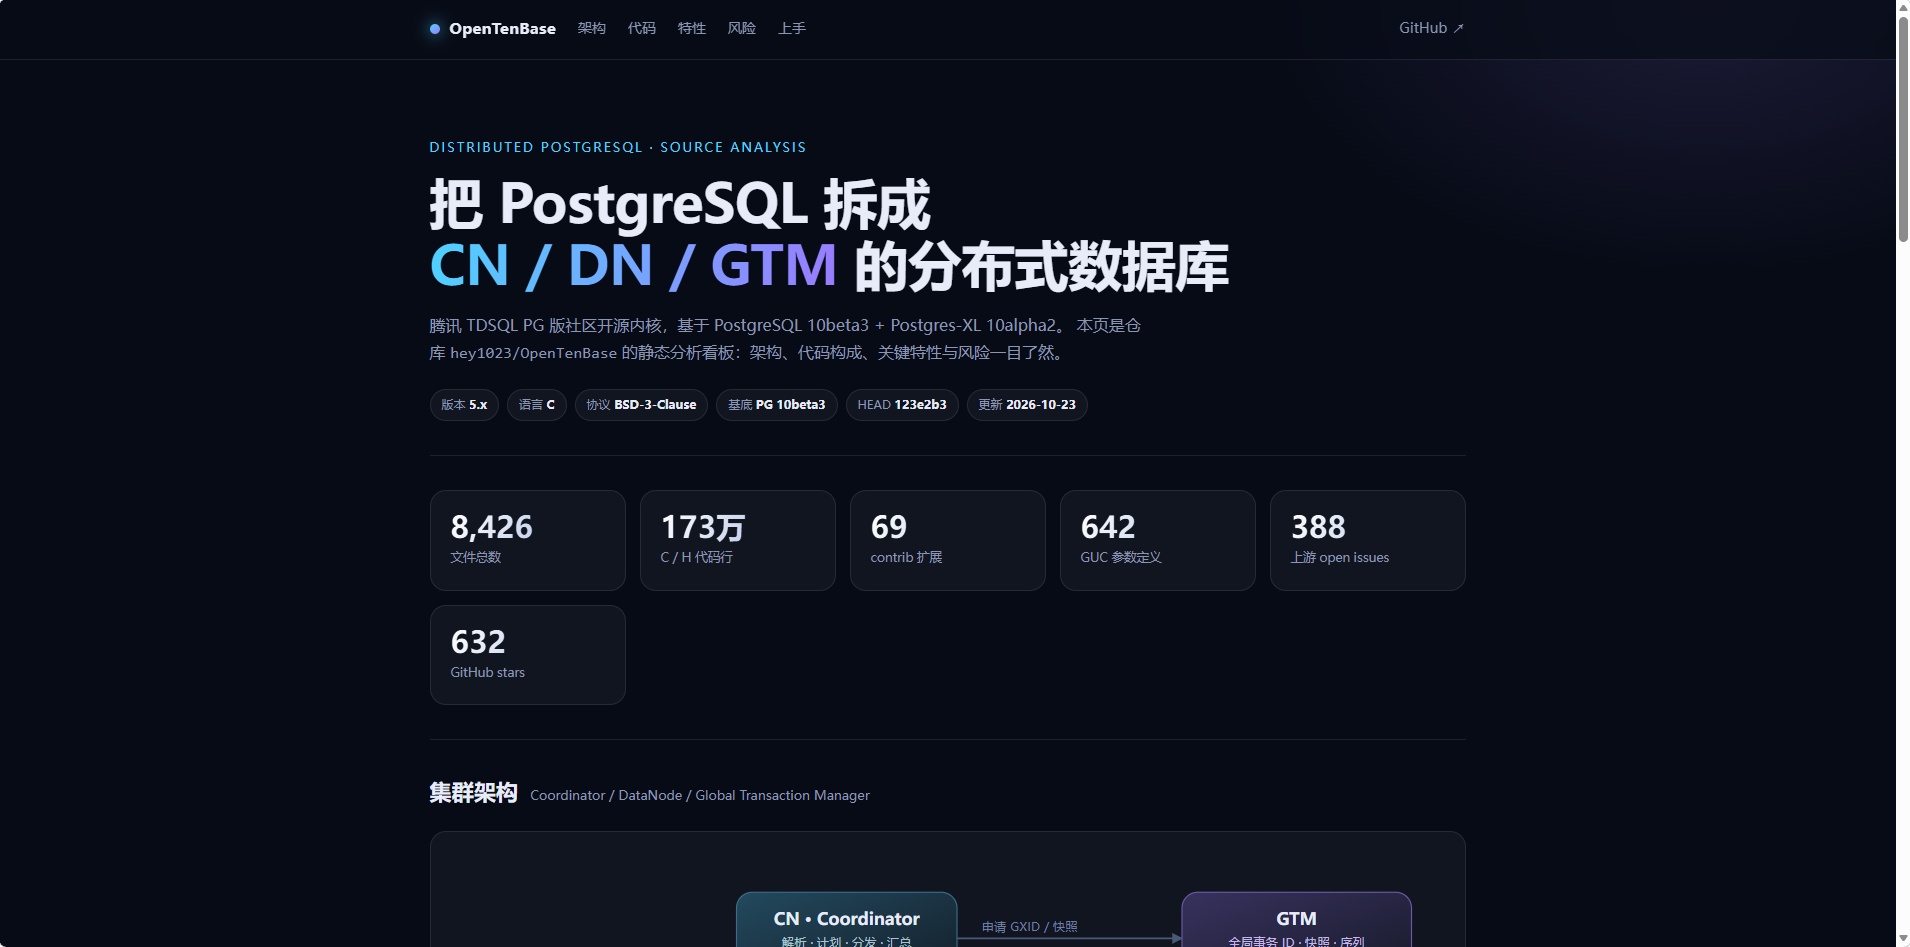
先看几个数字:
- 8,426 个文件,工作区 223 MB
- 1,617 个
.c、1,119 个.h,C 代码约 173 万行 - 642 个 GUC 参数定义,69 个 contrib 扩展
- GitHub 上 632 stars、388 个未关闭 issue
但行数会骗人。真正要看的是这些代码从哪来。
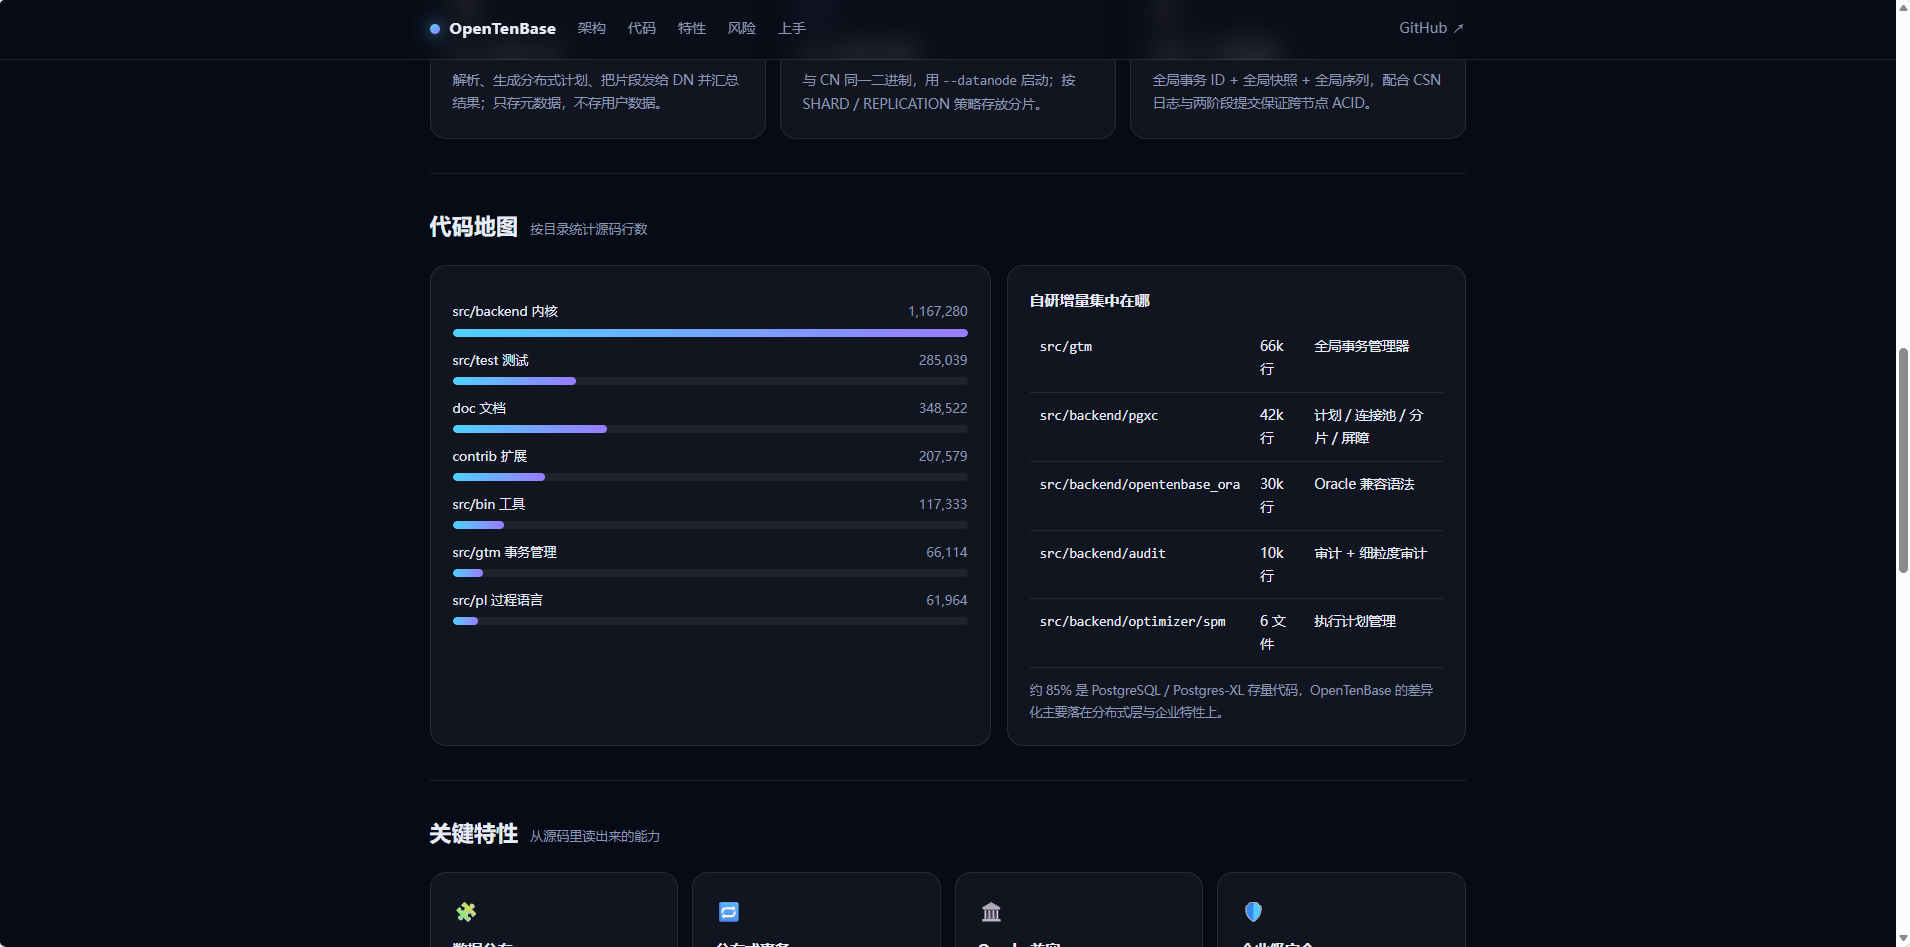
src/backend 一个目录就占了 116 万行,几乎就是完整的 PostgreSQL;doc 34 万行是官方文档;src/test 28 万行是回归测试。也就是说,绝大部分代码是继承来的。
OpenTenBase 自己的增量,集中在这么几个地方:
| 目录 | 规模 | 作用 |
|---|---|---|
src/gtm |
6.6 万行 | 全局事务管理器,含 Proxy、Standby、XLOG 复制 |
src/backend/pgxc |
4.2 万行 | 分布式计划、连接池、分片、屏障 |
src/backend/opentenbase_ora |
3 万行 | Oracle 兼容语法 |
src/backend/audit |
1 万行 | 审计与细粒度审计 |
optimizer/spm |
6 个文件 | 执行计划管理 |
一个比较好记的说法是:85% 的代码是别人的,15% 决定了它是不是一个分布式数据库。
三、五个发现
下面这五件事,文档里没写,但代码里写得明明白白。
发现一:默认连 HASH 分布都不让你用
如果你照着 Postgres-XL 的教程建表:
CREATE TABLE t (id int) DISTRIBUTE BY HASH(id);
会直接得到:
ERROR: distribute type "HASH" or "MODULO" is not enabled in this build
HINT: Rebuild OpenTenBase with --enable-alltype-distri ...
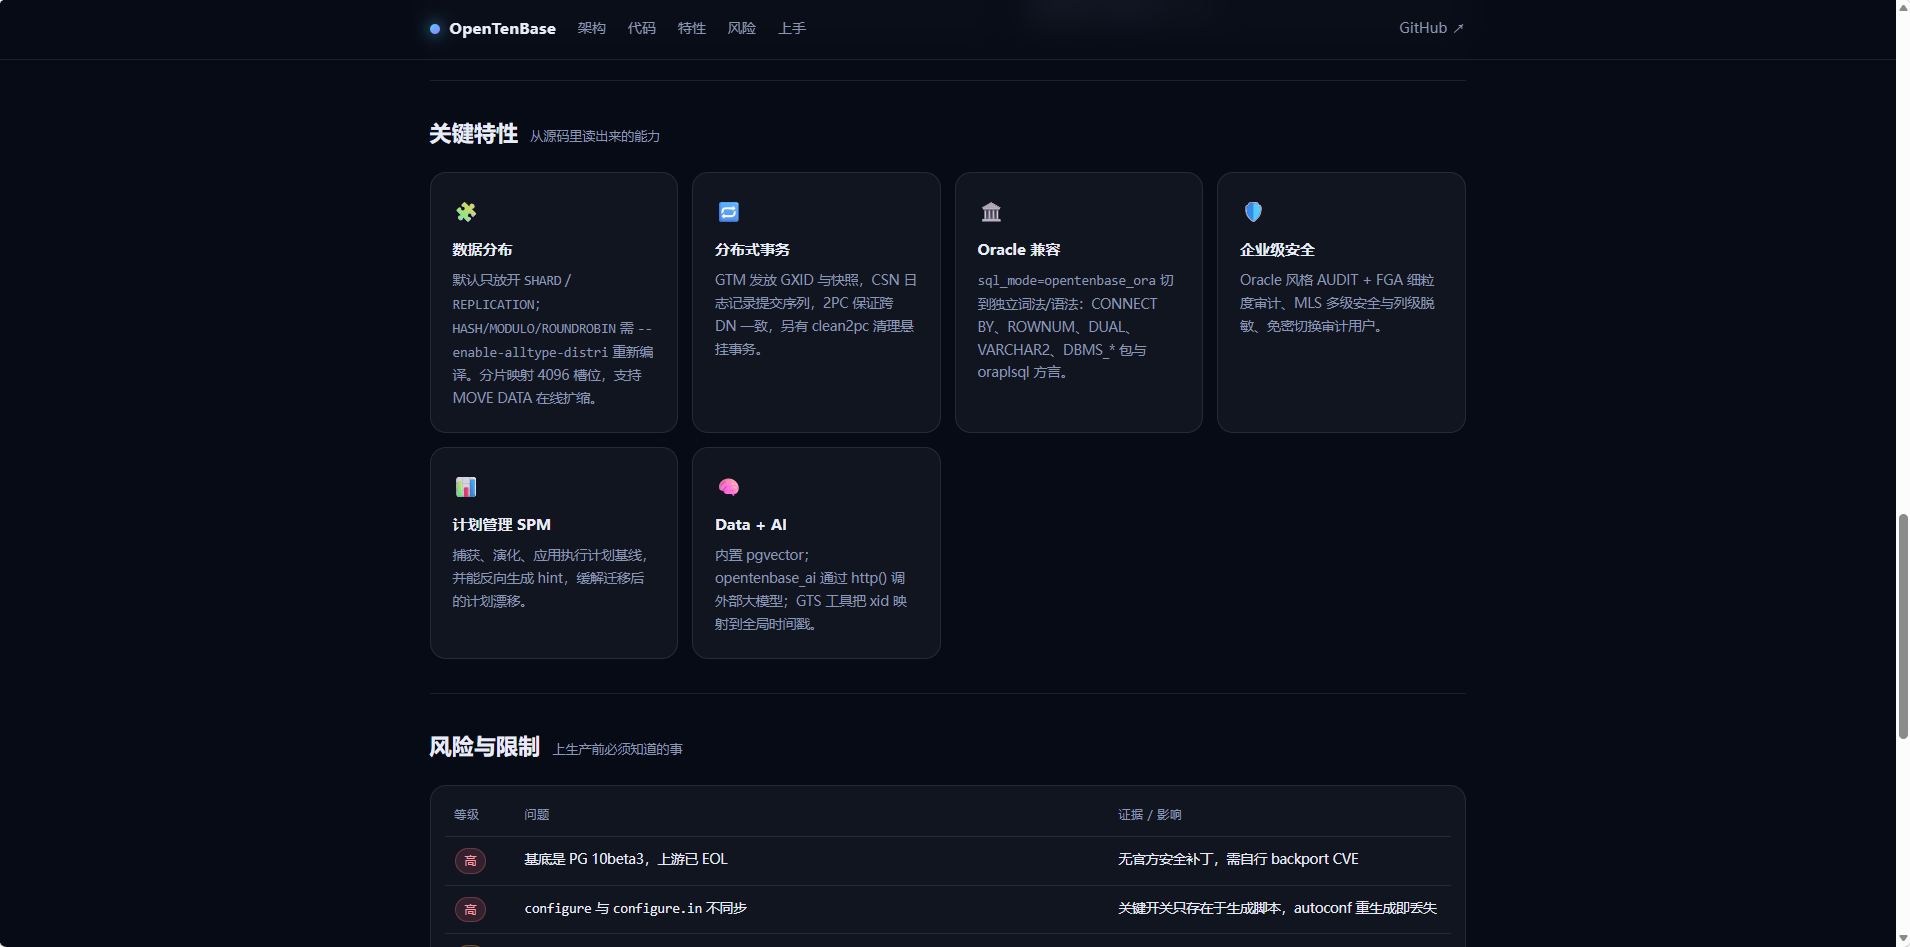
默认编译只放行 SHARD 和 REPLICATION 两种分布,HASH / MODULO / ROUNDROBIN 要加 --enable-alltype-distri 重新编译。代码里的判断在 tcop/utility.c,写得很显式。
这说明什么?说明在 TDSQL 的产品逻辑里,分片(SHARD)才是主线,Postgres-XL 那套 hash 分布只是保留能力。你如果拿 PGXL 的经验直接套,第一步就会卡住。
发现二:configure 和 configure.in 对不上
一个 Autoconf 项目,configure 是从 configure.in 生成的。
但在 OpenTenBase 里,--disable-license、--enable-alltype-distri、--enable-user-switch 这些关键选项,只存在于生成的 configure 脚本里,configure.in 里搜不到。
这意味着:谁要是习惯性跑一次 autoconf 重新生成,这些开关就全丢了。发布产物和源码不同步,是可复现构建的大忌。
顺带一提,configure 里还有个 --with-colblocksize(列存块大小),定义得一本正经,全仓库却没有任何一处使用它。列存内核在开源版里被剥离了,只留下这个空壳。
发现三:开源版里留着商业版的尾巴
src/backend/license/ 目录下,除了 license.c,还躺着 public.key 和 private.key。
许可证过期后,集群会变成只读——xact.c 里有一段 #ifndef NOLIC 的判断,过期就打印 “license expired or did not exist, cluster can only be read now”。
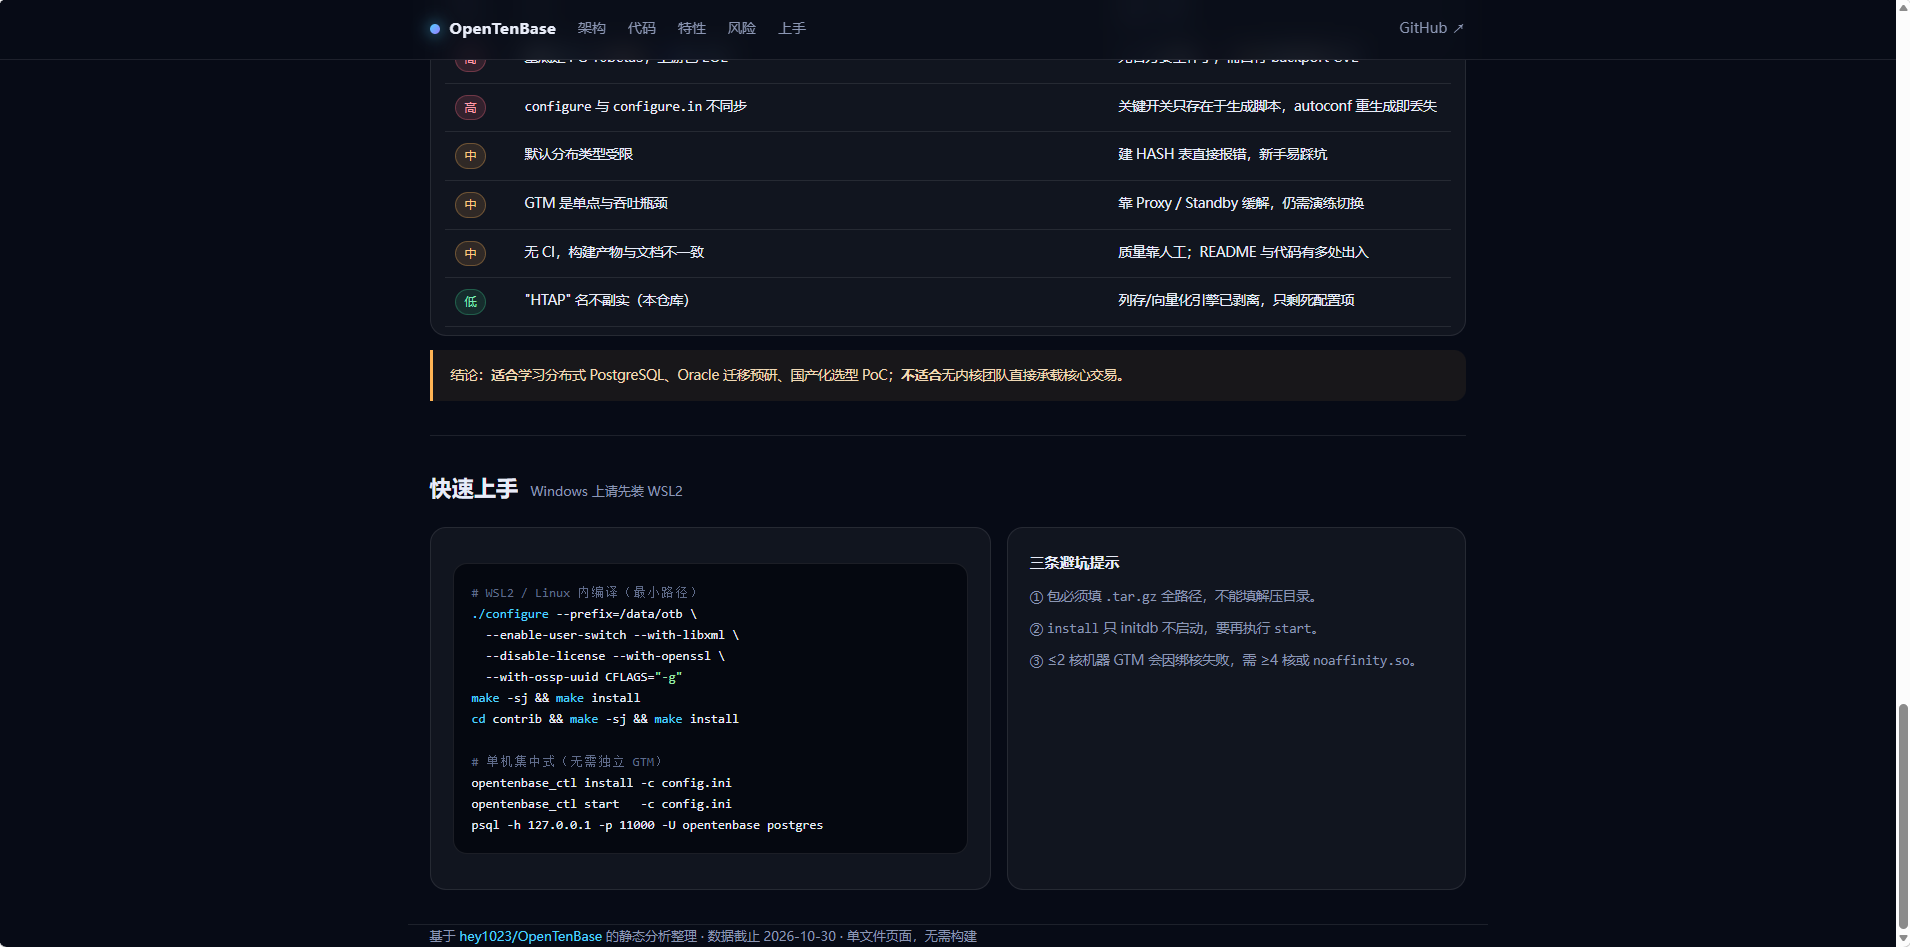
所以 README 才会在第一屏就教你加 --disable-license。
这件事本身不影响学习,但它传递了一个信号:开源版不等于商业版。列存是例子,许可证是例子,还有一些能力可能只存在于闭源分支里。评估选型时,这一点要算进去。
发现四:Oracle 兼容才是真卖点
如果说分布式是“骨架”,那 Oracle 兼容就是 OpenTenBase 最想卖的“肌肉”。
它不是加几个兼容函数那种敷衍,而是双词法 + 双语法:
- 通过
sql_mode = opentenbase_ora切换,同一个内核支持两套 SQL 方言; - 独立的
gram_ora.y,691 KB,比主语法文件还大; - 支持
CONNECT BY/START WITH/PRIOR,执行器里有专门的nodeConnectBy; - 支持
ROWNUM、DUAL、VARCHAR2、NUMBER这些 Oracle 数据类型; - 有独立的 PL/SQL 方言
oraplsql,支持包(PACKAGE)、游标、异常; - 还有一整套
DBMS_*系统包:DBMS_OUTPUT、DBMS_LOB、DBMS_RANDOM、DBMS_METADATA……
配套的还有 Oracle 风格的审计(AUDIT ... ON ... + 细粒度审计 FGA)和 SPM 执行计划管理。
它兼容的不是 Oracle 的语法,是 Oracle 用户的习惯。 对迁移项目来说,这比多几个功能实在。
发现五:GTM 是命门
全局事务 ID、全局快照、全局序列,全在 GTM 里。DN 上的每一次跨节点提交,都要和它打交道;一致性靠 GTM 发放的 GXID、CSN 提交序列号,再加两阶段提交兜底。
这套设计很经典,也很好理解,代价是:GTM 是单点,也是吞吐瓶颈。GTM-Proxy 和 Standby 能缓解切换问题,但消除不了这个中心。
一个很能说明问题的细节:GTM 启动时会按 CPU 核数做线程绑核。在 ≤2 核的机器上,pthread_setaffinity_np 会失败,进程直接报 FATAL: binding threads failed 起不来。README 把它列为已知问题,建议换 ≥4 核机器,或者用 noaffinity.so 绕过去。
连启动都这么“挑机器”,说明它是按高性能场景设计的——也说明它对部署环境有要求。
四、谁适合用,谁别碰
适合:
- 想学分布式数据库内核的人。CN/DN/GTM 三件套、全局快照、2PC、下推优化、分片映射,代码齐全且能编译,是很好的教材;
- 有 Oracle 迁移预研需求的项目。拿它跑一遍存量 PL/SQL,能快速摸出兼容性边界;
- 国产化选型的 PoC 阶段。它有 TDSQL 血缘和真实案例,值得进候选名单,但一定要和 TiDB、OceanBase、openGauss 放在一起压测。
不建议:
- 没有 DBA 或内核团队,直接拿它扛核心交易;
- 期待“开箱即用的 HTAP”。列存和向量化不在这个仓库里,AP 场景要实测;
- 在 Windows 上开发。核心路径直接依赖
epoll、prctl,非 Linux 环境编译不过,老老实实用 WSL2。
五、最后
如果把数据库比作车,OpenTenBase 更像一辆改装得很彻底的老底盘:底盘是 PG 10,改装件是分布式事务、分片、Oracle 兼容。它能开,而且有些路况只有它能开;但你要会修车,也要接受它偶尔挑路。
它不值得被神化,也不该被一句“套壳”打发。能把 PostgreSQL 改成这样,背后的工程量是真实的;而它留下的那些坑,同样真实。
源码在 GitHub,搜 OpenTenBase 就能找到。下一篇我想聊聊它的分片映射:4096 个槽位、MOVE DATA、以及数据到底是怎么搬的。感兴趣的话,点个关注。
数据来自 2026-10-30 的 master 分支(commit 123e2b3),行数为脚本统计口径。